Зачем измерять алгоритмы
Одна и та же программа быстро работает на новом компьютере и медленно на старом. Поэтому секунды — плохой способ сравнивать два алгоритма: это число зависит от машины, а не только от кода.
Вместо этого мы считаем шаги: сколько простых операций выполняет алгоритм. Шаг — это одно маленькое действие, например чтение значения, сравнение двух чисел или их сложение.
Нотация Big O описывает, как растёт число шагов, когда растут входные данные. Она не говорит «это занимает 3 секунды». Она говорит «если входные данные удваиваются, работа удваивается» — это O(n) — или «если входные данные удваиваются, работа остаётся прежней» — это O(1).
Big O рассматривает худший случай: наибольшее число шагов, которое может понадобиться алгоритму для входных данных размера n.
Подсчёт шагов
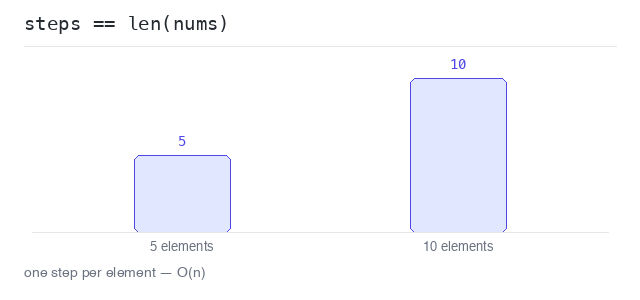
Цикл, который обходит каждый элемент списка, делает один проход на элемент. Для 5 элементов это 5 шагов, для 10 элементов — 10 шагов. Число шагов равно len(nums).
Нас не интересует точное число. Нас интересует форма роста: вдвое больше входных данных — вдвое больше шагов. Такая форма называется линейной и записывается как O(n).
Подсчёт шагов цикла
Функция увеличивает счётчик steps внутри цикла. Список из 5 элементов занимает 5 шагов, список из 10 элементов — 10 шагов: число шагов следует за размером входных данных.
Вывод: полная программа на Python
def count_steps(nums):
  steps = 0
  total = 0
  for n in nums:
    total += n
    steps += 1
  print("сумма:", total)
  return steps

small = [2, 4, 6, 8, 10]
big = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

print("шагов для 5 элементов:", count_steps(small))
print("шагов для 10 элементов:", count_steps(big))
Удвоение входных данных удваивает работу
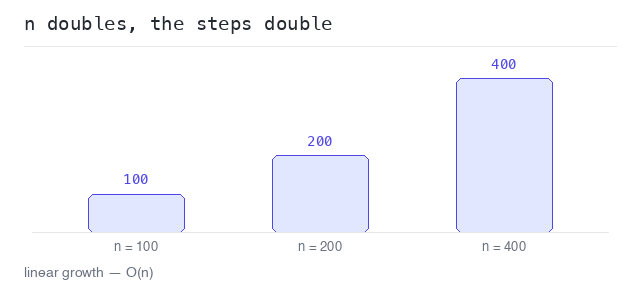
Программа запускает один и тот же цикл подсчёта для n = 100, 200 и 400. Каждый раз, когда n удваивается, число шагов тоже удваивается. Это отличительный признак O(n).
Вывод: полная программа на Python
for n in [100, 200, 400]:
  steps = 0
  for i in range(n):
    steps += 1
  print(f"n = {n:>3} -> шагов: {steps:>3}")
Классы роста
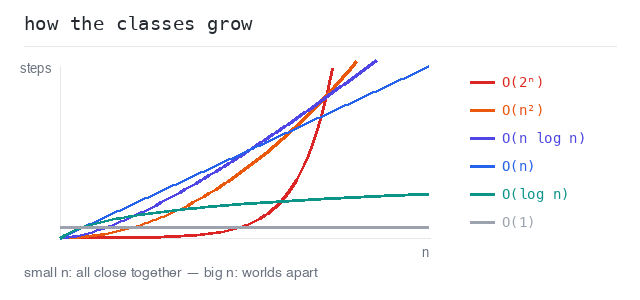
Большинство алгоритмов относится к нескольким распространённым классам роста, от самого быстрого к самому медленному:
O(1) постоянное — работа никогда не растёт.O(log n) логарифмическое — удвоение входных данных добавляет всего один шаг.O(n) линейное — работа растёт вместе с входными данными.O(n log n) — хороший алгоритм сортировки.O(n²) квадратичное — цикл внутри цикла.O(2ⁿ) экспоненциальное — работа удваивается с каждым дополнительным элементом.
Для небольших входных данных разница крошечная. Для больших она решает, ответит ли программа сразу или не закончит работу никогда.
Сравнение классов роста
Таблица показывает число шагов при растущем n. При n = 16 значение log n равно всего 4, а 2ⁿ уже 65536. Чем больше становится n, тем сильнее расходятся классы.
Вывод: полная программа на Python
import math

print(f"{'n':>5} {'log n':>7} {'n':>5} {'n log n':>9} {'n^2':>6} {'2^n':>8}")
for n in [1, 2, 4, 8, 16]:
  logn = math.log2(n)
  print(f"{n:>5} {logn:>7.0f} {n:>5} {n * logn:>9.0f} {n * n:>6} {2 ** n:>8}")
Что игнорирует Big O
Big O сохраняет только форму роста и отбрасывает детали. O(2n), O(n + 5) и O(n) — это один и тот же класс: линейный.
Почему? Потому что для больших входных данных постоянный множитель перестаёт иметь значение. Алгоритм, который делает 2 прохода по миллиону элементов, всё равно находится в совершенно другом мире, чем алгоритм, сравнивающий каждый элемент с каждым другим элементом.
Точные правила упрощения — отбрасывать константы, отбрасывать меньшие слагаемые — описаны на отдельной странице далее в этой группе.
Два цикла — всё равно O(n)
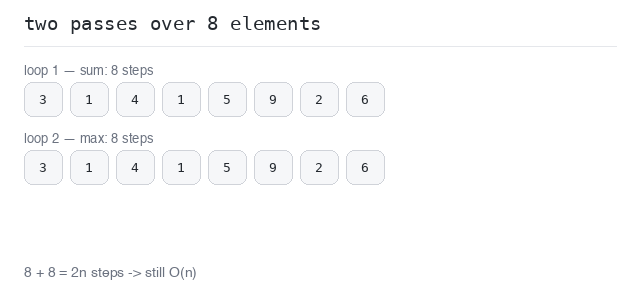
Программа делает два отдельных прохода по списку: один для суммы, другой для наибольшего значения. Это 2n шагов — 16 для 8 элементов. Big O отбрасывает константу 2, поэтому это всё равно O(n).
Вывод: полная программа на Python
nums = [3, 1, 4, 1, 5, 9, 2, 6]
steps = 0

total = 0
for n in nums:
  total += n
  steps += 1

biggest = nums[0]
for n in nums:
  if n > biggest:
    biggest = n
  steps += 1

print("сумма:", total)
print("максимум:", biggest)
print("элементов:", len(nums))
print("шагов:", steps)