Делим задачу пополам
O(log n) означает логарифмическое время: каждый шаг уменьшает оставшуюся работу вдвое. Поскольку деление пополам очень быстро уменьшает числа, удвоение входных данных добавляет всего один лишний шаг.
Для 16 элементов нужно 4 деления пополам, для 32 — 5, для миллиона — около 20, для миллиарда — около 30. Вот почему логарифмические алгоритмы работают практически мгновенно даже на огромных данных.
Классический пример — бинарный поиск, но он работает только с отсортированными данными. Чтобы делить пополам, нужен порядок: только так можно понять, какую половину отбросить.
Цикл с делением пополам
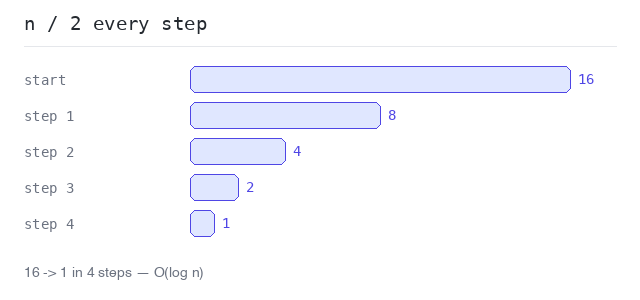
Проще всего увидеть O(log n) на цикле, который делит n на 2, пока не дойдёт до 1. Количество повторений равно логарифму n: при n = 16 цикл выполняется 4 раза, потому что 2 · 2 · 2 · 2 = 16.
Делим пополам, пока не останется единица
16 превращается в 8, 4, 2, 1 — четыре шага. Если удвоить n до 32, добавится всего один шаг. Оператор // выполняет целочисленное деление, поэтому n остаётся целым числом (int).
Вывод: полная программа на Python
n = 16
steps = 0

while n > 1:
  n = n // 2
  steps += 1
  print("теперь n =", n)

print("16 стало 1 за", steps, "шага")
Бинарный поиск
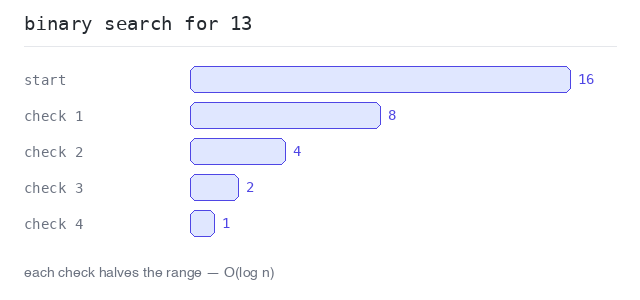
Бинарный поиск находит значение в отсортированном списке, каждый раз проверяя средний элемент. Если средний элемент слишком мал, вся левая половина отбрасывается; если слишком велик — правая. Каждая проверка вдвое сокращает диапазон поиска.
Два маркера, lo и hi, хранят текущий диапазон. Цикл завершается, когда значение найдено или диапазон стал пустым.
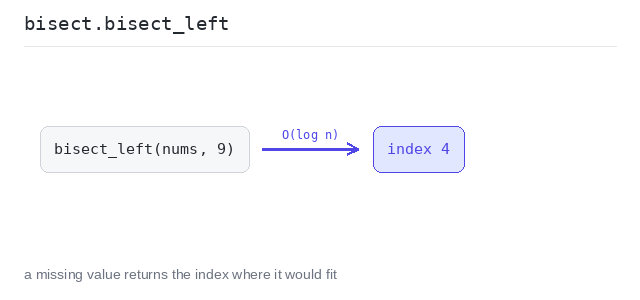
В Python есть и готовое решение: функция bisect.bisect_left() из стандартной библиотеки возвращает индекс, где значение должно находиться в отсортированном списке. Если значения нет, этот индекс указывает позицию, куда его можно вставить.
Бинарный поиск шаг за шагом
В отсортированном списке из 16 чисел поиск числа 13 требует всего 4 проверки: диапазон сокращается 16 → 8 → 4 → 2 и останавливается на индексе 6. Линейному поиску здесь понадобилось бы 7 шагов, а в худшем случае — до 16.
Вывод: полная программа на Python
nums = [1, 3, 5, 7, 9, 11, 13, 15, 17, 19, 21, 23, 25, 27, 29, 31]
target = 13
steps = 0

lo, hi = 0, len(nums) - 1
while lo <= hi:
  steps += 1
  mid = (lo + hi) // 2
  if nums[mid] == target:
    print("значение", target, "найдено по индексу", mid, "за", steps, "проверки")
    break
  if nums[mid] < target:
    lo = mid + 1
  else:
    hi = mid - 1
Бинарный поиск с модулем bisect
bisect.bisect_left() находит 9 по индексу 4, а сравнение nums[i] со значением подтверждает, что оно найдено. Для отсутствующего значения 10 получается индекс 5 — место, куда нужно вставить 10, чтобы список остался отсортированным, — и сравнение выводит False.
Вывод: полная программа на Python
import bisect

nums = [1, 3, 5, 7, 9, 11, 13, 15]

i = bisect.bisect_left(nums, 9)
print("индекс:", i, "найдено:", i < len(nums) and nums[i] == 9)

i = bisect.bisect_left(nums, 10)
print("индекс:", i, "найдено:", i < len(nums) and nums[i] == 10)
O(n log n): сортировка
O(n log n) находится между линейным и квадратичным временем — это сложность хороших алгоритмов сортировки: данные снова и снова делятся пополам (log n уровней), и на каждом уровне выполняется линейный объём работы (n).
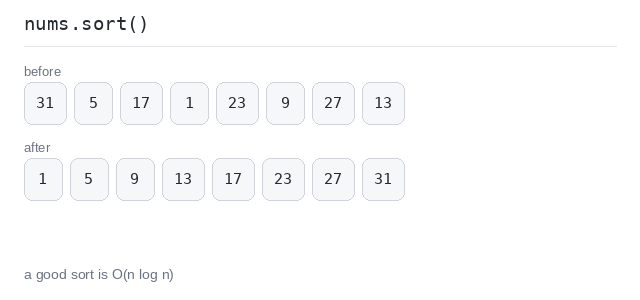
В Python редко приходится писать сортировку самому: nums.sort() упорядочивает список на месте, а sorted(nums) возвращает новый отсортированный список; оба варианта работают за O(n log n). Отсортировать один раз, а затем много раз выполнять бинарный поиск — распространённый и быстрый приём.
Сортировка списка
nums.sort() упорядочивает 8 чисел примерно за 8 · log 8 = 24 шага — гораздо меньше, чем 64 шага квадратичной сортировки, и разрыв быстро растёт по мере роста списка.
Вывод: полная программа на Python
nums = [31, 5, 17, 1, 23, 9, 27, 13]

nums.sort()

print(nums)