Цикл внутри цикла
O(n²) означает квадратичное время: объём работы растёт пропорционально квадрату размера входных данных. Вдвое больше элементов — вчетверо больше шагов. В десять раз больше элементов — в сто раз больше шагов.
Характерный признак в коде — цикл внутри цикла, причём оба проходят по одним и тем же данным. Внешний цикл выполняется n раз, и на каждой его итерации внутренний цикл снова выполняется n раз: n · n шагов.
Для небольших списков квадратичное время вполне допустимо. Но для 100 000 элементов это уже 10 миллиардов шагов — именно здесь программы начинают зависать.
Все пары
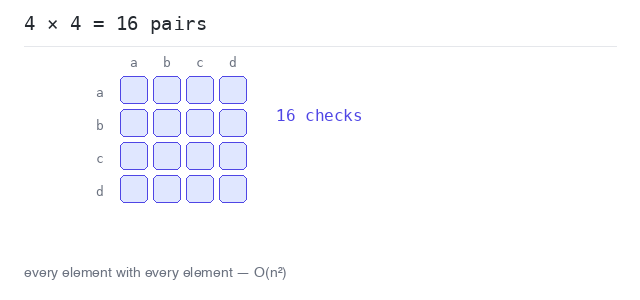
Самая прямолинейная задача O(n²): сочетать каждый элемент с каждым элементом. 4 буквы дают 4 · 4 = 16 пар; 100 букв дали бы 10 000.
Построение всех пар
Внешний цикл выбирает x, а внутренний составляет из него пару с каждым y. 4 элемента дают 16 пар — квадрат размера входных данных.
Вывод: полная программа на Python
letters = ["a", "b", "c", "d"]
pairs = 0

for x in letters:
  for y in letters:
    print(x + y, end=" ")
    pairs += 1
  print()

print("из", len(letters), "элементов получено", pairs, "пар")
Пузырьковая сортировка
Пузырьковая сортировка — классический квадратичный алгоритм: она раз за разом проходит по списку и меняет местами соседние элементы, стоящие в неправильном порядке. Большие значения «всплывают» в конец, по одному проходу за раз.
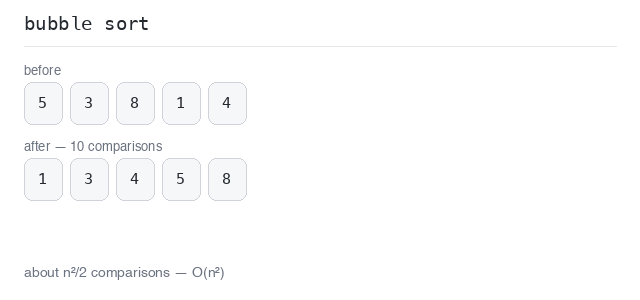
С двумя вложенными циклами она выполняет около n²/2 сравнений. Это отличный алгоритм, чтобы на нём учиться, — и плохой, чтобы его использовать: nums.sort() делает ту же работу за O(n log n).
Сортировка двумя вложенными циклами
Сортировка 5 элементов требует 4 + 3 + 2 + 1 = 10 сравнений. Для 1 000 элементов их было бы около полумиллиона — тогда как сортировке за O(n log n) нужно около десяти тысяч.
Вывод: полная программа на Python
nums = [5, 3, 8, 1, 4]
comparisons = 0

for i in range(len(nums) - 1):
  for j in range(len(nums) - 1 - i):
    comparisons += 1
    if nums[j] > nums[j + 1]:
      nums[j], nums[j + 1] = nums[j + 1], nums[j]

print("отсортировано:", nums)
print("сравнений:", comparisons)
Поиск дубликатов медленным способом
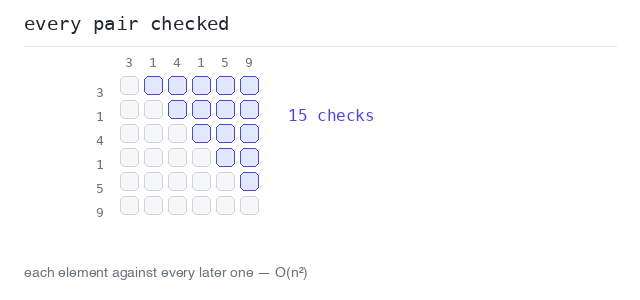
Сравнение каждого элемента с каждым элементом, идущим после него, — ещё один шаблон с вложенными циклами: чтобы найти дубликат, сравниваются все пары.
Это работает, но за O(n²). На странице о пространственной сложности в этом разделе показан стандартный приём, который делает поиск линейным: запоминать уже встреченные значения во множестве.
Поиск дубликата двумя циклами
Каждый элемент сравнивается с каждым последующим элементом. Пара повторяющихся единиц находится после 7 проверок; в худшем случае — когда дубликатов нет вовсе — выполняются все 15 проверок пар.
Вывод: полная программа на Python
nums = [3, 1, 4, 1, 5, 9]
checks = 0

for i in range(len(nums)):
  for j in range(i + 1, len(nums)):
    checks += 1
    if nums[i] == nums[j]:
      print("дубликат:", nums[i], "после", checks, "проверок")