Extragerea părților dintr-o colecție
Uneori nu ai nevoie de o listă întreagă. Ai nevoie de o parte din ea: un interval de elemente, primele sau ultimele câteva, bucăți de aceeași mărime sau o fereastră de vecini care se deplasează.
Python are o singură sintaxă pentru majoritatea acestor lucruri: felia (slice). words[low:high] dă elementele de la indexul low până la indexul high, fără a-l include. Omite low ca să începi de la început sau omite high ca să mergi până la sfârșit. Un index negativ numără înapoi de la sfârșit, iar un al treilea număr stabilește un pas.
s[low:high]— de la indexullowpână lahigh, fără a-l includes[:n]— primelenelementes[n:]— totul de la indexulnpână la sfârșits[-n:]— ultimelenelementes[::2]— fiecare al doilea element
O felie construiește întotdeauna o listă nouă și copiază în ea elementele alese. Modificarea copiei nu modifică originalul, iar modificarea originalului nu modifică copia. În alte limbaje aceeași operație dă o vedere care împarte memoria cu originalul — în Python nu se întâmplă niciodată așa.
Pentru sarcinile pe care o felie nu le poate face singură, această lecție folosește funcții din modulul itertools și una-două funcții ajutătoare mici.
Majoritatea exemplelor de pe această pagină folosesc aceleași date: cuvintele one two three four five six.
Felia
A tăia o felie înseamnă a lua elementele de pe anumite poziții alese.
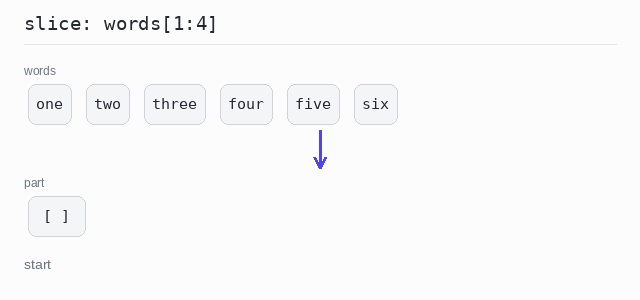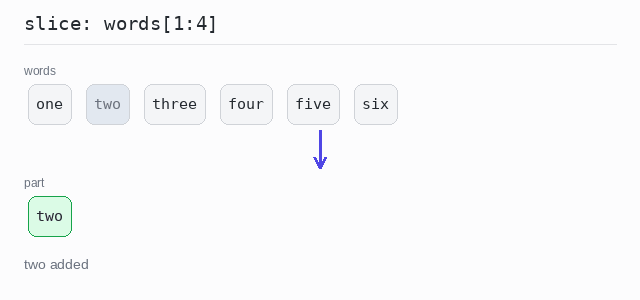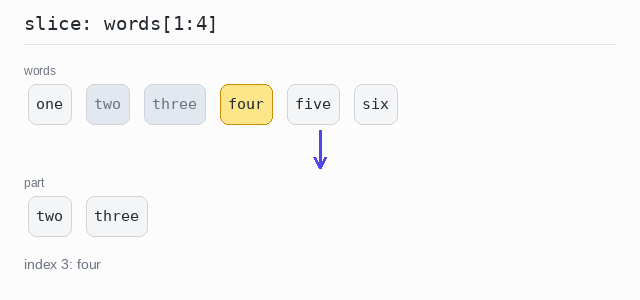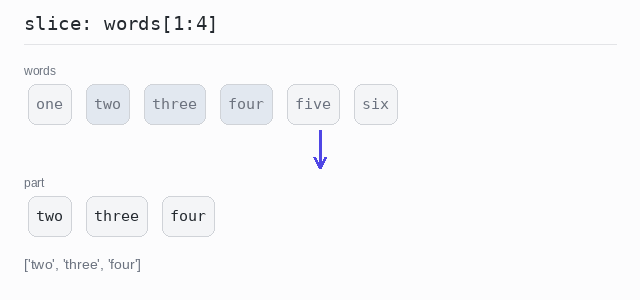
Pentru un șir de poziții vecine, folosește o felie: words[1:4] dă elementele de la indexurile 1, 2 și 3. Ține minte că indexul de final este exclus: ca să obții elementele de la indexurile 1 până la 3, scrii 1:4.
O felie poate chiar să sară peste elemente: al treilea număr este pasul, așa că words[::2] ia fiecare al doilea element. Pentru poziții pe care le enumeri tu, în ordinea ta, folosește o comprehensiune de listă peste o listă de indexuri.
Felie dintr-un interval
words[1:4] începe la indexul 1 și se oprește înainte de indexul 4. Rezultatul are 3 elemente: ['two', 'three', 'four']. Este o listă nouă, așa că o modificare a ei nu ar atinge words.
Ieșire: program Python complet
words = ["one", "two", "three", "four", "five", "six"]

# indexurile 1, 2 și 3 - indexul de final 4 nu este inclus
part = words[1:4]

print(part)
Felie cu pas
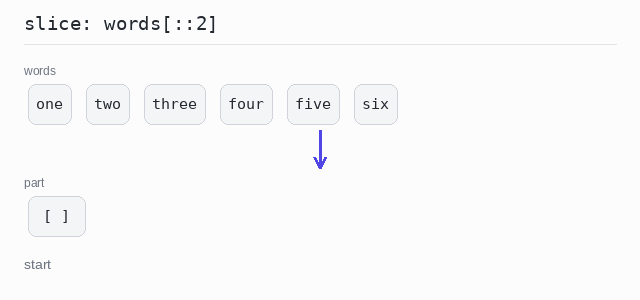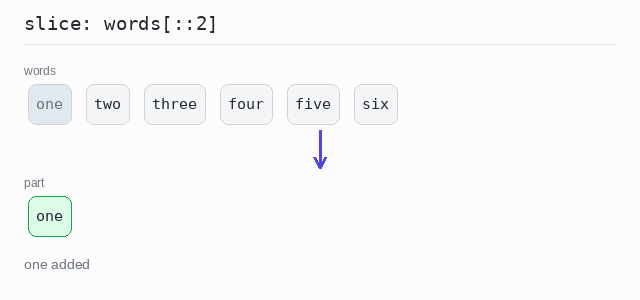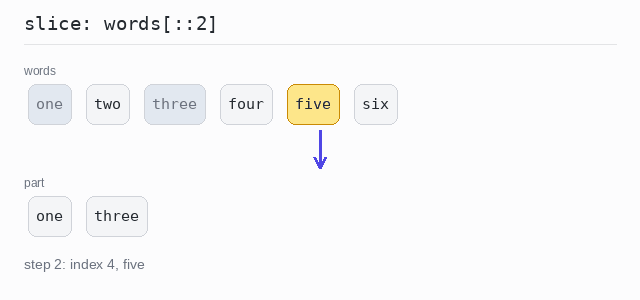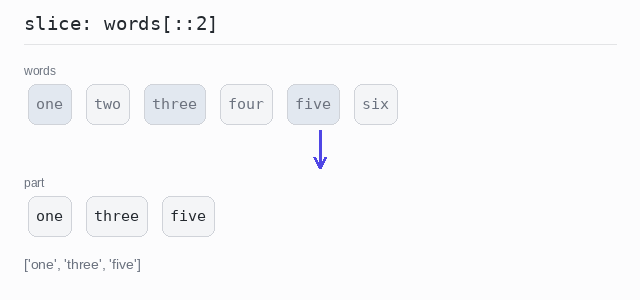
Felia words[::2] are începutul și sfârșitul goale, deci acoperă toată lista, iar pasul 2 ia fiecare al doilea element: indexurile 0, 2 și 4. Nu e nevoie de nicio buclă — pasul face parte din sintaxa feliei.
Ieșire: program Python complet
words = ["one", "two", "three", "four", "five", "six"]

# al treilea număr al feliei este pasul: fiecare al doilea element
part = words[::2]

print(part)
Felie după o listă de indexuri
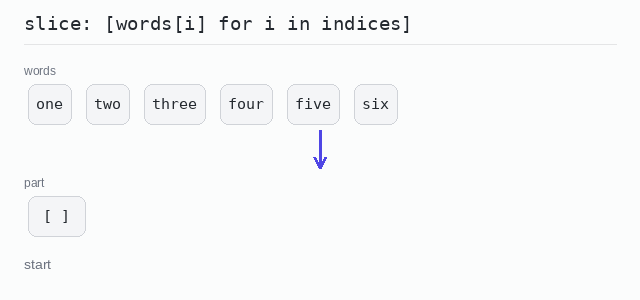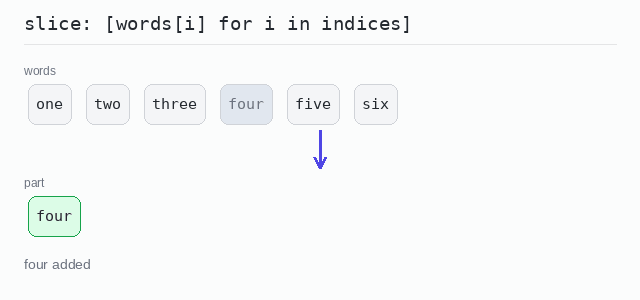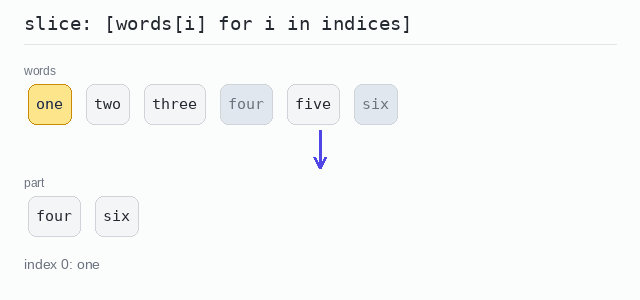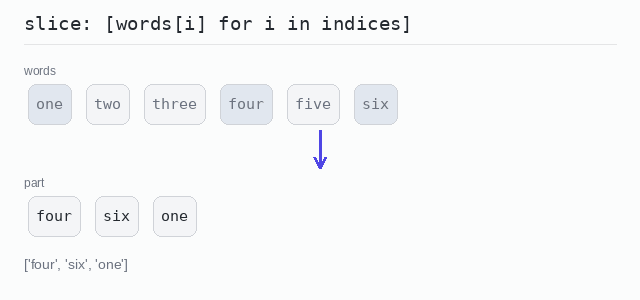
Pozițiile 3, 5 și 0 sunt păstrate într-o listă de numere. Comprehensiunea alege cuvântul de pe fiecare poziție, așa că rezultatul iese în ordinea indexurilor.
Ieșire: program Python complet
words = ["one", "two", "three", "four", "five", "six"]
indices = [3, 5, 0]

# alege elementele de pe pozițiile date, în acea ordine
part = [words[i] for i in indices]

print(part)
Take și Drop
Take (a lua) înseamnă a păstra un număr de elemente de la un capăt. Drop (a arunca) înseamnă a elimina un număr de elemente de la un capăt și a păstra restul.
În Python, ambele sunt felii. words[:3] ia primele 3 elemente, iar words[-3:] ia ultimele 3. words[1:] elimină primul element, iar words[:-5] elimină ultimele 5.
Există și variante condiționale. Acestea nu numără elemente: pornesc de la un capăt și se opresc la primul element care nu îndeplinește o condiție. Python le are gata făcute, în modulul itertools: takewhile() păstrează elemente de la început cât timp o condiție este adevărată, iar dropwhile() sare peste elemente cât timp ea este adevărată și păstrează restul. Ambele întorc un iterator leneș, așa că pune apelul în list() ca să vezi elementele. Pentru aceleași sarcini de la sfârșitul listei nu există o funcție încorporată: rulează funcția peste reversed(words) și întoarce rezultatul înapoi cu [::-1].
Ia primele sau ultimele n elemente
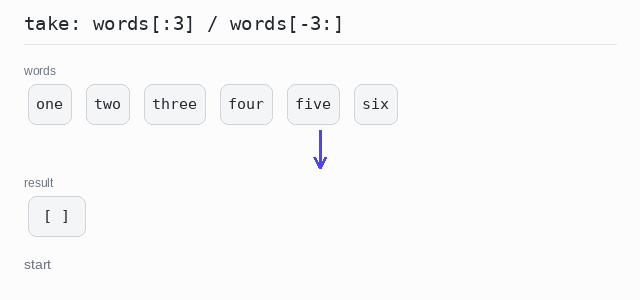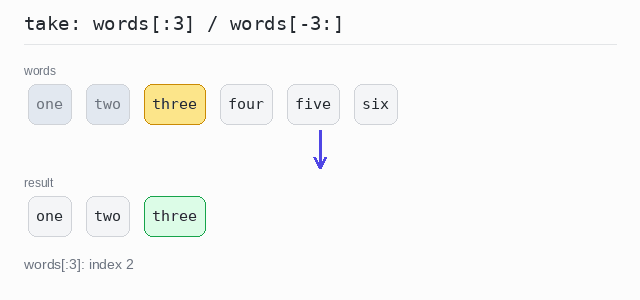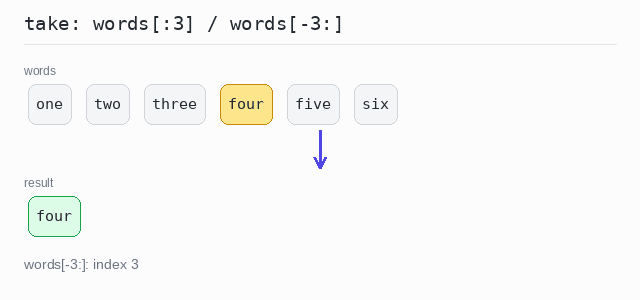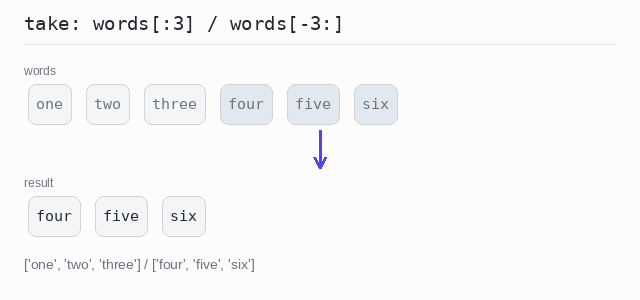
words[:3] păstrează primele 3 cuvinte. words[-3:] le păstrează pe ultimele 3, pentru că un index negativ numără înapoi de la sfârșit.
Ieșire: program Python complet
words = ["one", "two", "three", "four", "five", "six"]

first3 = words[:3]  # primele 3 elemente
last3 = words[-3:]  # ultimele 3 elemente

print(first3)
print(last3)
Elimină primele sau ultimele n elemente
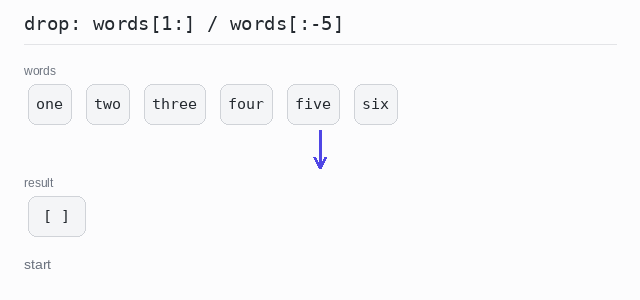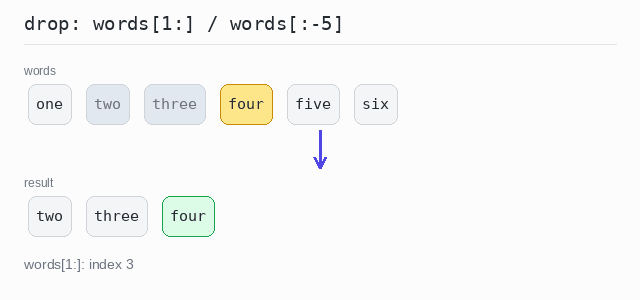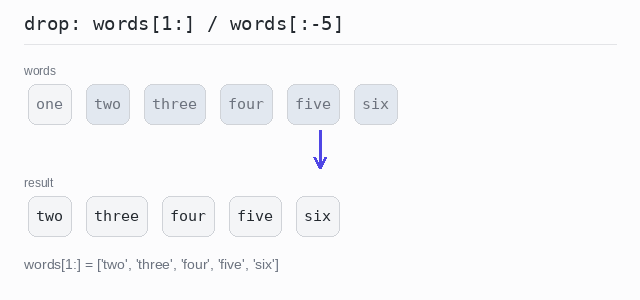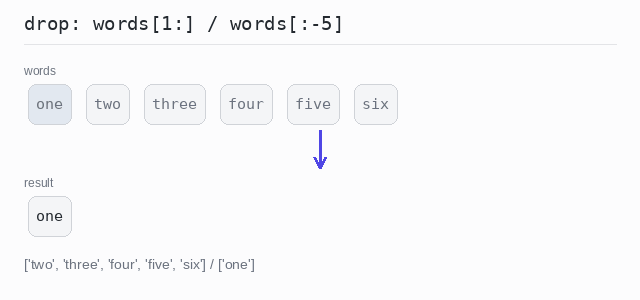
words[1:] sare peste primul cuvânt. words[:-5] sare peste ultimele 5 cuvinte, așa că rămâne doar one.
Ieșire: program Python complet
words = ["one", "two", "three", "four", "five", "six"]

without_first = words[1:]   # elimină primul element
without_last5 = words[:-5]  # elimină ultimele 5 elemente

print(without_first)
print(without_last5)
Ia cât timp o condiție este adevărată
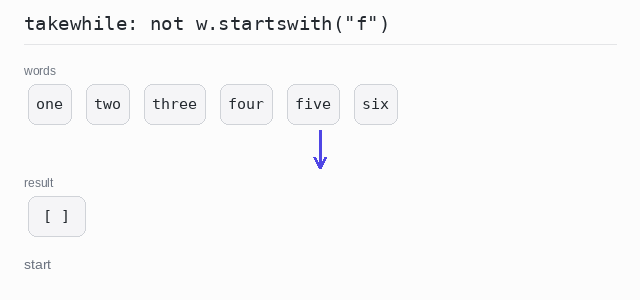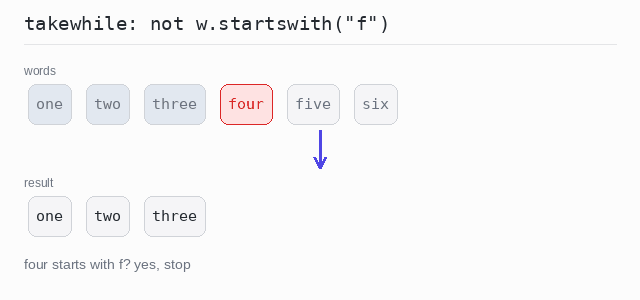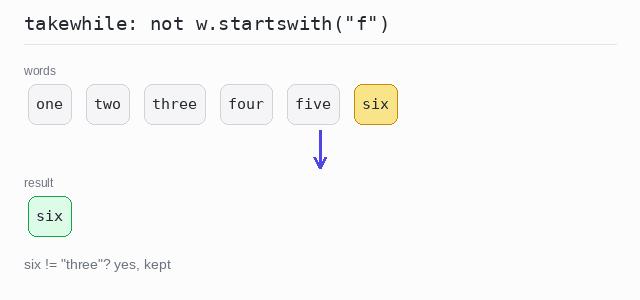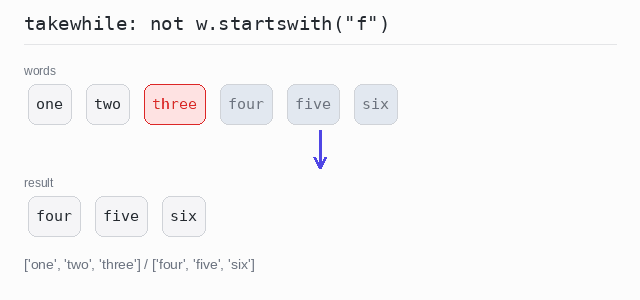
takewhile() păstrează cuvinte de la început până când întâlnește un cuvânt care începe cu f. Condiția este un lambda, o funcție mică fără nume, iar startswith() verifică începutul unui șir. Pentru sfârșitul listei, takewhile() rulează peste reversed(words) — păstrează cuvinte până când întâlnește three — iar [::-1] întoarce rezultatul înapoi.
Ieșire: program Python complet
from itertools import takewhile

words = ["one", "two", "three", "four", "five", "six"]

# păstrează de la început cât timp cuvântul nu începe cu „f”
from_start = list(takewhile(lambda w: not w.startswith("f"), words))

# la fel de la sfârșit: parcurge lista inversată, apoi întoarce rezultatul înapoi
from_end = list(takewhile(lambda w: w != "three", reversed(words)))[::-1]

print(from_start)
print(from_end)
Elimină cât timp o condiție este adevărată
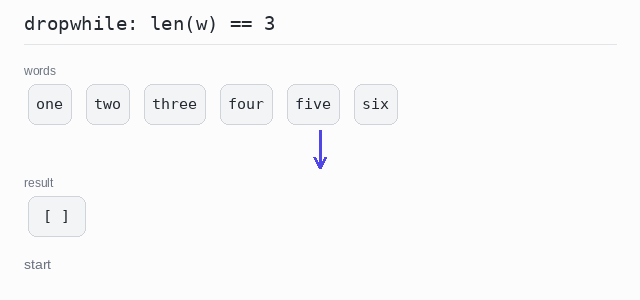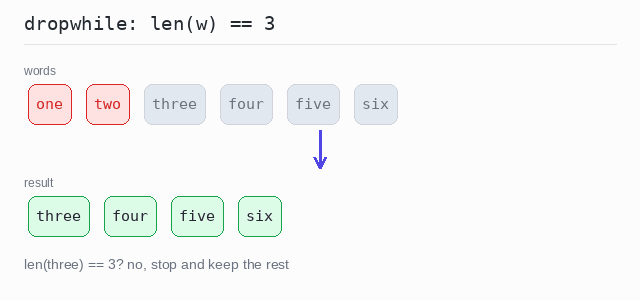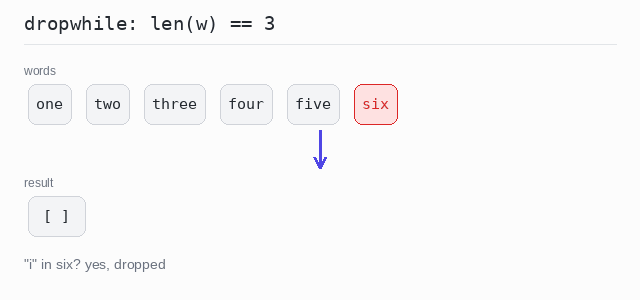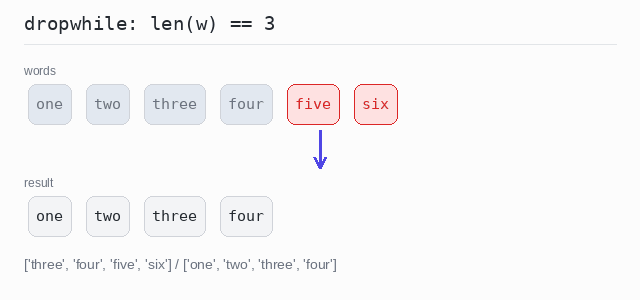
dropwhile() sare peste cuvintele de 3 litere de la început și păstrează totul începând cu three. Același truc cu reversed() sare peste cuvintele de la sfârșit cât timp conțin litera i. Operatorul in verifică dacă un șir conține o bucată de text.
Ieșire: program Python complet
from itertools import dropwhile

words = ["one", "two", "three", "four", "five", "six"]

# sari peste cuvintele de la început cât timp au 3 litere, păstrează restul
from_start = list(dropwhile(lambda w: len(w) == 3, words))

# la fel de la sfârșit: parcurge lista inversată, apoi întoarce rezultatul înapoi
from_end = list(dropwhile(lambda w: "i" in w, reversed(words)))[::-1]

print(from_start)
print(from_end)
Împărțirea în bucăți (chunked)
Împărțirea în bucăți înseamnă tăierea unei liste în bucăți de aceeași mărime. Ultima bucată poate fi mai scurtă când elementele nu se împart exact.
Această versiune de Python nu are o funcție încorporată pentru bucăți (versiunile mai noi adaugă itertools.batched()), dar funcția ajutătoare are un singur rând: range(0, len(items), size) dă indexurile de început 0, 3, 6, …, iar o felie taie câte o bucată de la fiecare. O felie nu citește niciodată dincolo de sfârșitul listei, așa că ultima bucată, cea scurtă, iese corect de la sine.
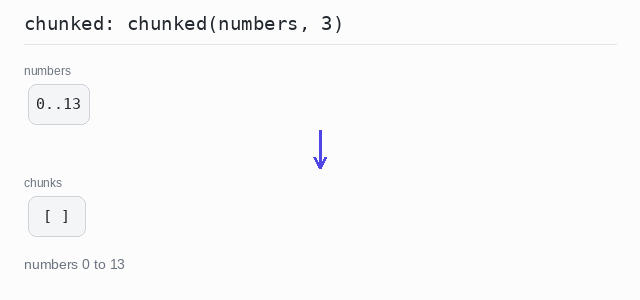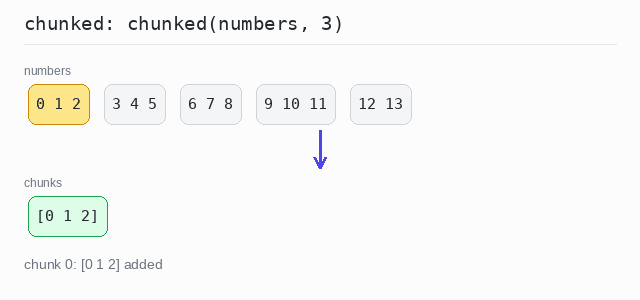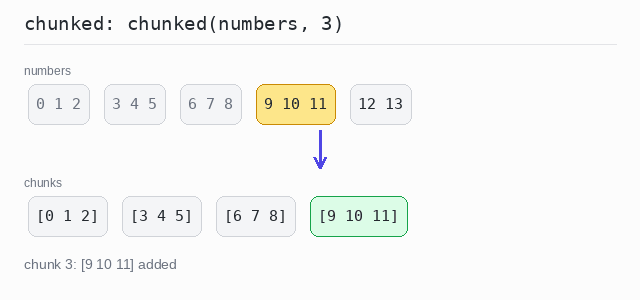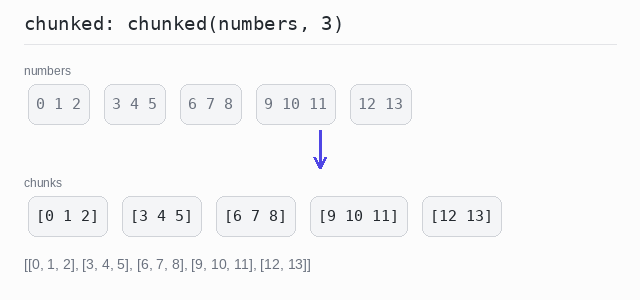
Rezultatul este o listă de liste, iar fiecare bucată își păstrează propriile paranteze: [[0, 1, 2], [3, 4, 5], …].
Ca să lucrezi imediat cu fiecare bucată, pune bucățile într-o comprehensiune.
Împarte în bucăți de câte 3
Numerele de la 0 la 13 sunt tăiate în bucăți de câte 3. Ultima bucată are doar 2 elemente: [12, 13].
Ieșire: program Python complet
def chunked(items, size):
  # câte o felie pentru fiecare bucată: începuturile sunt 0, size, 2*size, ...
  return [items[i:i + size] for i in range(0, len(items), size)]

numbers = list(range(14))

chunks = chunked(numbers, 3)

print(chunks)
Adună fiecare bucată
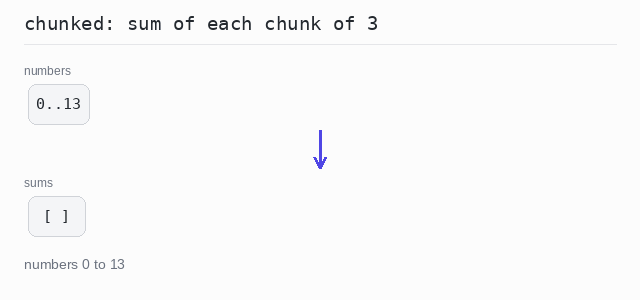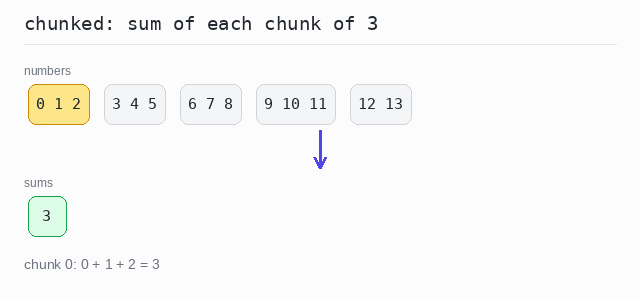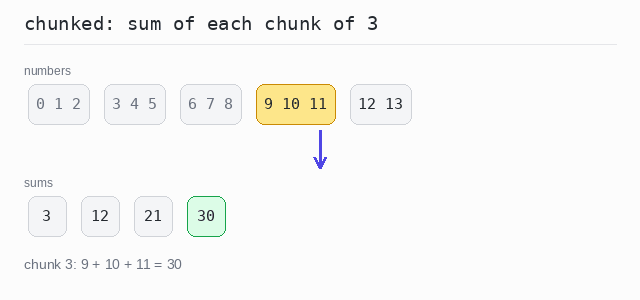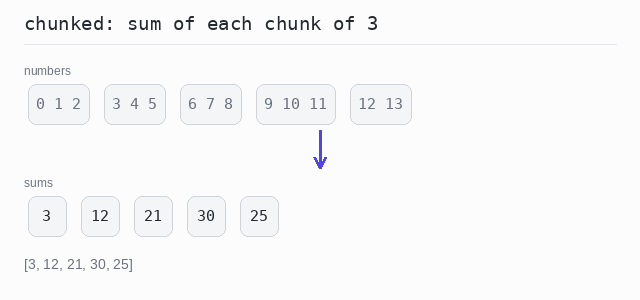
Aceleași bucăți, dar fiecare este adunată cu funcția încorporată sum(). Se păstrează doar sumele: [3, 12, 21, 30, 25].
Ieșire: program Python complet
def chunked(items, size):
  return [items[i:i + size] for i in range(0, len(items), size)]

numbers = list(range(14))

# adună fiecare bucată de 3, păstrează doar sumele
sums = [sum(chunk) for chunk in chunked(numbers, 3)]

print(sums)
Ferestre (windowed)
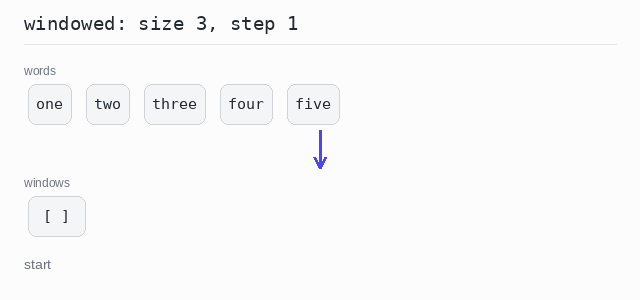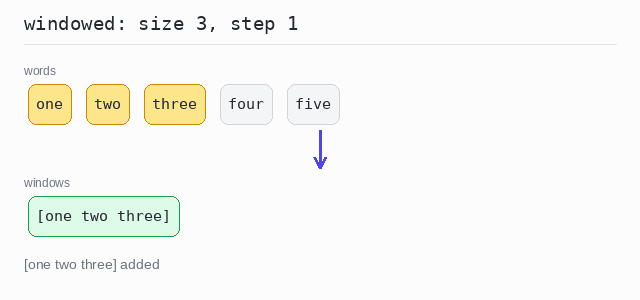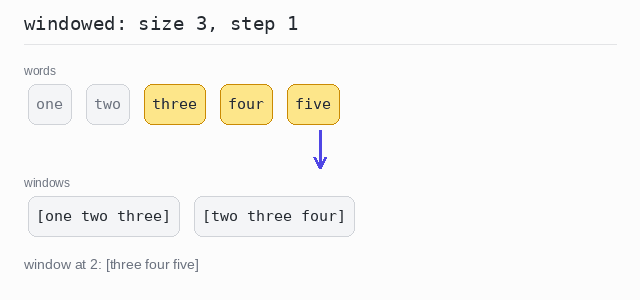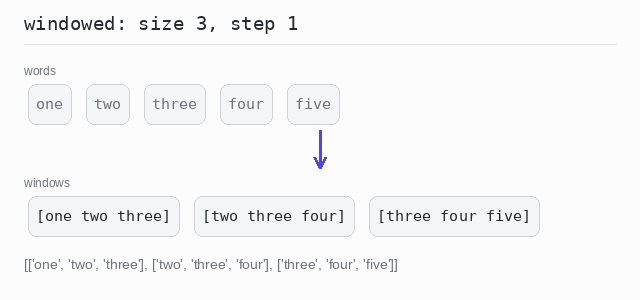
O fereastră este un grup de elemente vecine. Metoda ferestrelor glisează grupul de-a lungul listei și adună fiecare poziție. Spre deosebire de bucăți, ferestrele se suprapun.
Python nu are o funcție încorporată windowed. O comprehensiune cu items[i:i + size] face acest lucru, iar o mică funcție ajutătoare windowed o face reutilizabilă. Cu un step (pas), fereastra se mută cu mai multe poziții deodată. Cu partial setat la True, o fereastră mai scurtă de la sfârșit este păstrată în loc să fie aruncată.
O fereastră de 2 care se mută cu 1 pas este același lucru cu împerecherea fiecărui element cu următorul. În Python, acesta este idiomul clasic zip(words, words[1:]) — iar modulul itertools îl are gata făcut ca pairwise().
Ferestre de câte 3
Fereastra are 3 cuvinte și se mută de fiecare dată cu 1 poziție. range(len(items) - size + 1) se oprește când o fereastră completă nu mai încape, așa că sunt 3 ferestre. Rezultatul este o listă de liste, afișată pe un singur rând.
Ieșire: program Python complet
def windowed(items, size):
  # fiecare grup de size vecini, mutându-se cu câte o poziție
  return [items[i:i + size] for i in range(len(items) - size + 1)]

words = ["one", "two", "three", "four", "five"]

print(windowed(words, 3))
Ferestre cu pas și ferestre parțiale
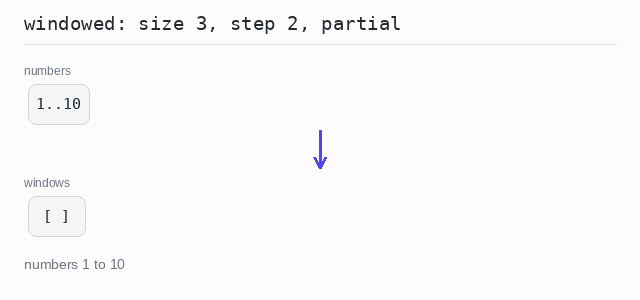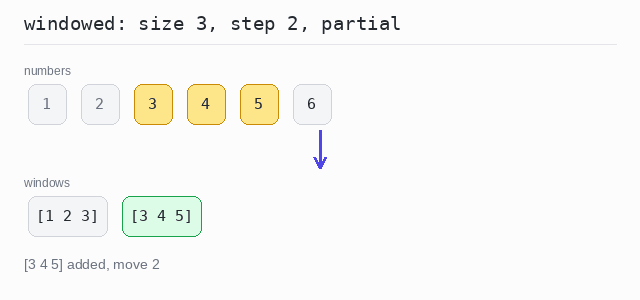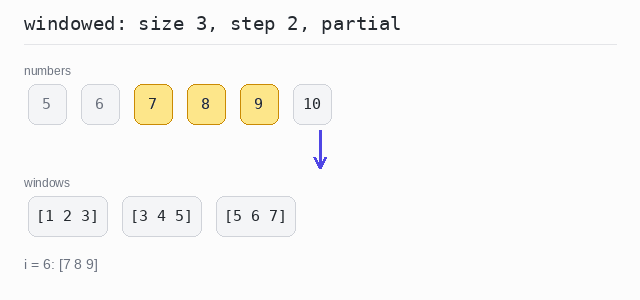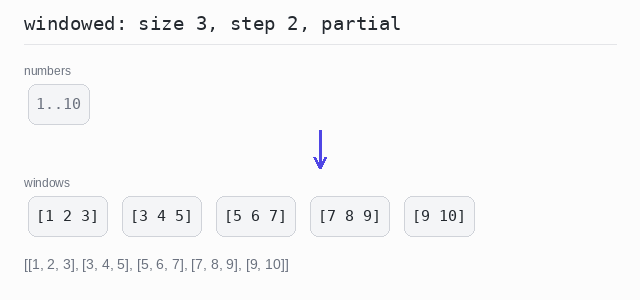
Fereastra are 3 numere și se mută de fiecare dată cu 2 poziții. Pentru că partial este True, ultima fereastră [9, 10] este păstrată, chiar dacă este scurtă.
Ieșire: program Python complet
def windowed(items, size, step=1, partial=False):
  result = []
  for i in range(0, len(items), step):
    window = items[i:i + size]
    if len(window) < size and not partial:
      break
    result.append(window)
  return result

numbers = list(range(1, 11))

print(windowed(numbers, 3, step=2, partial=True))
Adună fiecare fereastră
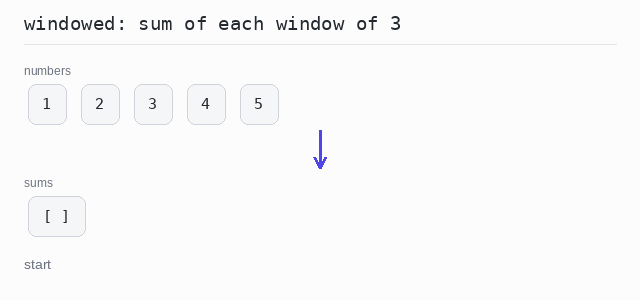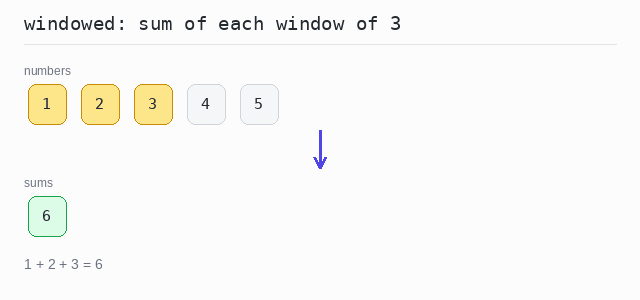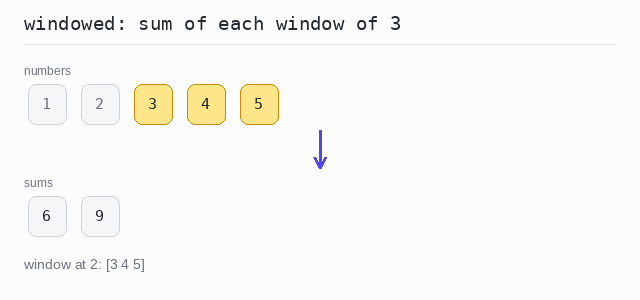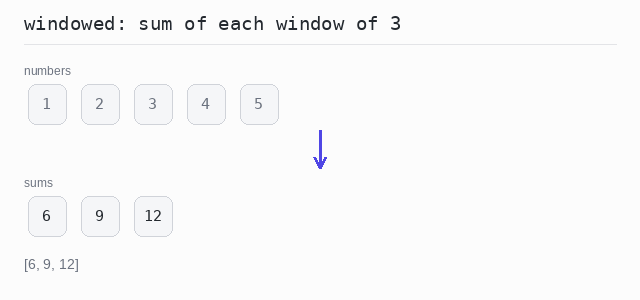
Fiecare fereastră de 3 vecini este adunată cu sum(). Se păstrează doar sumele: [6, 9, 12].
Ieșire: program Python complet
numbers = [1, 2, 3, 4, 5]

# adună fiecare fereastră de 3 vecini, păstrează doar sumele
sums = [sum(numbers[i:i + 3]) for i in range(len(numbers) - 2)]

print(sums)
Împerechează fiecare element cu următorul
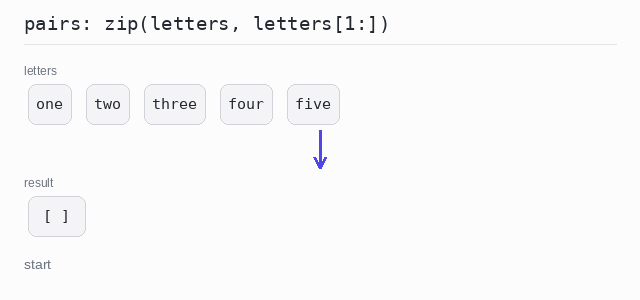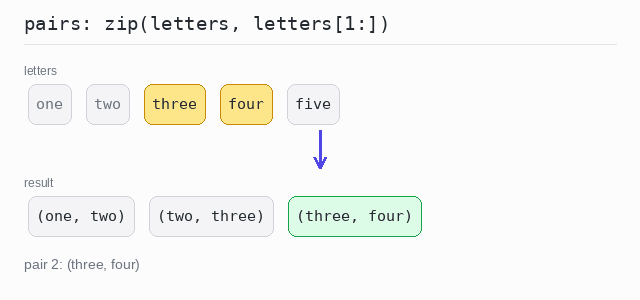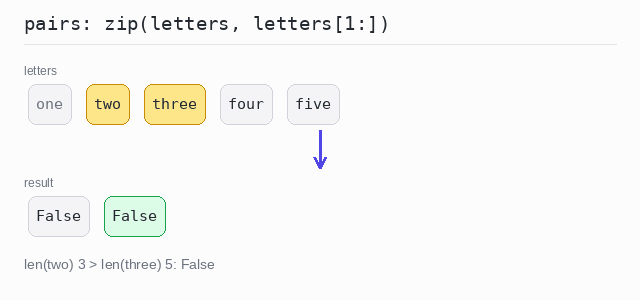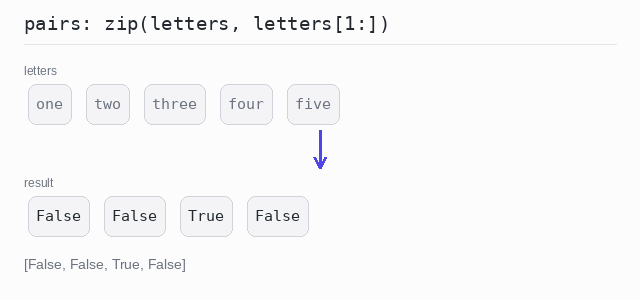
zip(letters, letters[1:]) împerechează fiecare cuvânt cu vecinul lui. Fiecare pereche este un tuplu, afișat între paranteze rotunde: ('one', 'two'). itertools.pairwise() dă aceleași perechi gata făcute; aici alimentează o comprehensiune care notează dacă primul cuvânt este mai lung decât al doilea.
Ieșire: program Python complet
from itertools import pairwise

letters = ["one", "two", "three", "four", "five"]

# fiecare element împreună cu cel de după el, ca tupluri
pairs = list(zip(letters, letters[1:]))
print(pairs)

# aceiași vecini din itertools.pairwise, comparați după lungime
longer = [len(a) > len(b) for a, b in pairwise(letters)]
print(longer)